Token/cí yuán · 名词
- 词汇: Token / 词元
- 拼音: cí yuán
- 词性: 名词
- 分类: AI与科技
- 热度: 核心网络流行词
- 相关领域: 人工智能、大语言模型(LLM)、自然语言处理(NLP)、AIGC、全网计费黑话
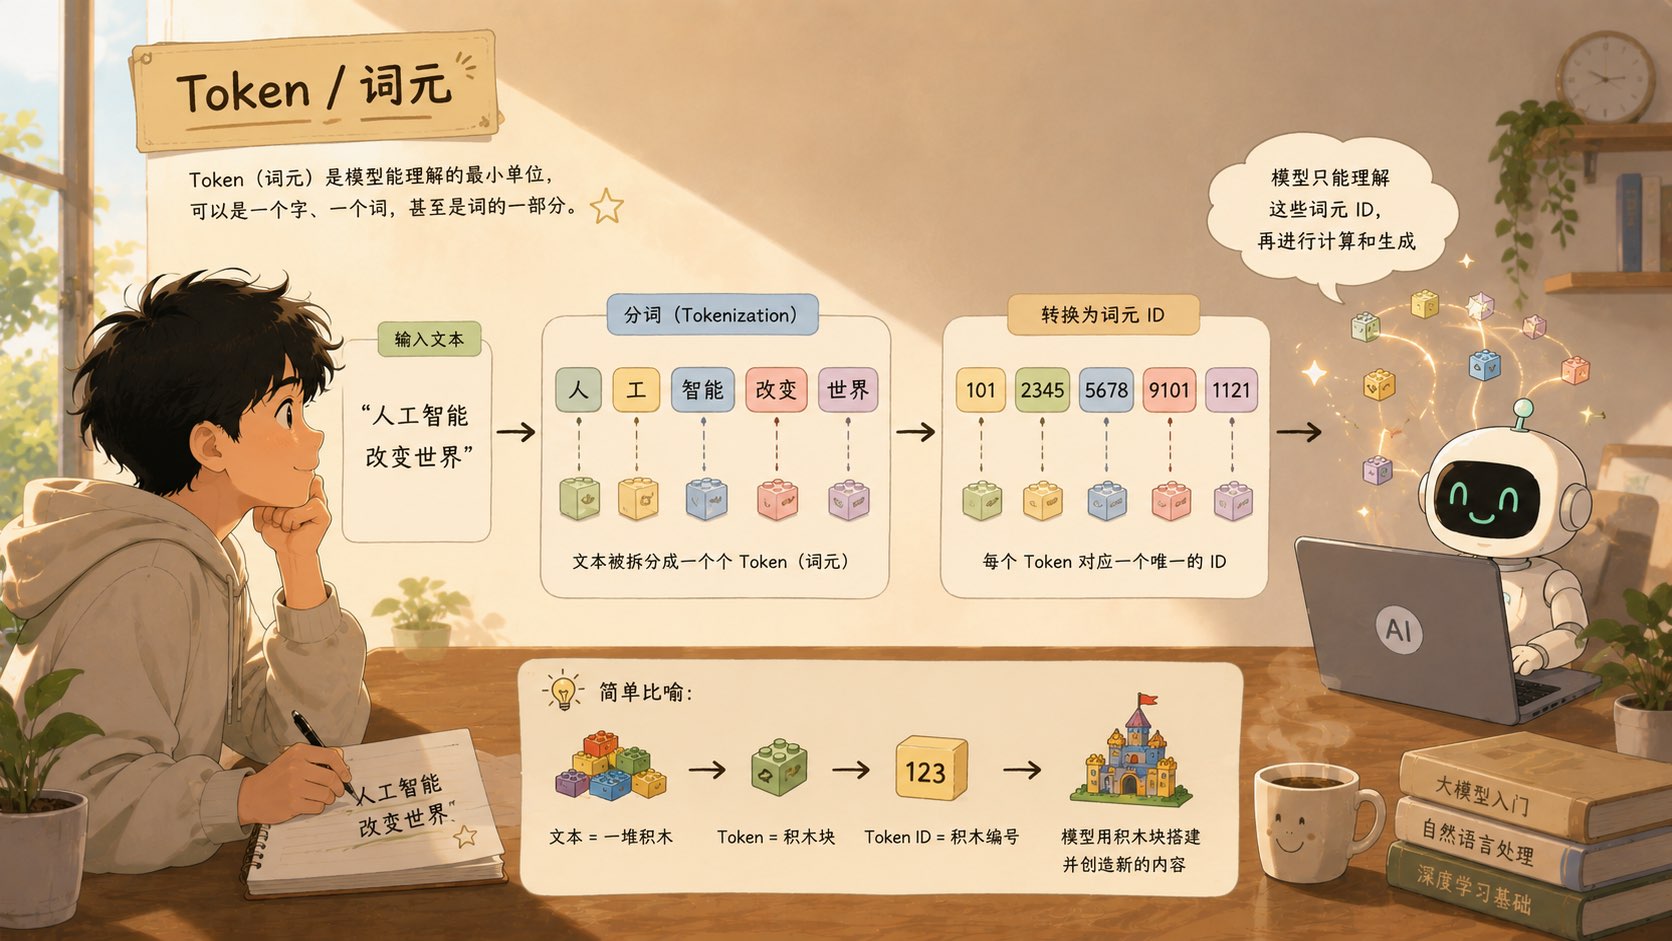
大语言模型处理文本时文本片段的最小计量单位。简单来说,就是AI大模型阅读和写字时的“基本汉字/单词字符块”,既是AI的“记忆力和脑容量”,也是当代打工人调用AI时最核心的“省钱与计费算力密码”。
什么是“Token/词元”?
“Token”(在自然语言处理领域常被翻译为“词元”或“令牌”)最初是计算机网络和密码学中的专业术语,指网络中传输的令牌或身份验证的凭证。在AI大模型(LLM)的底层逻辑中,它代表文本流被切分后的基本语义单元,可以是一个单词、一个音节、甚至半个汉字。
2023年随着以 ChatGPT 为代表的生成式 AI 在全球范围内迎来史诗级爆发,各大AI厂商(如 OpenAI、Anthropic)在面向公众和企业提供API服务时,均统一采用“每千个 Token($0.0015/1K tokens)”作为核心计费与算力消耗的标准单位,使得该词在小红书、独立开发者圈子以及大厂技术部大范围曝光并迅速进入大众视野。
然而,在当前的中文互联网与职场语境下,该词被广大的新时代打工人和数字游民进行了一次极具搞怪与黑色幽默色彩的“职场能量解构” [10]。现代意义上的“Token / 词元”,已经不仅仅是一个冰冷的AI计费单位,而是延伸成了当代人用来形容个人精神、体力和耐心极限的算力黑话。它精准地指代那些“我每天早上的精神额度只有 100 个 Token,开完这个无聊的周会,我的 Token 就已经彻底消耗完毕、直接进入脑死亡状态的紧绷和空耗”。
例句: 别跟我长篇大论对齐颗粒度了,我今天的大脑 Token 已经欠费,现在只想下班。
“Token”为什么会流行?
“Token”之所以能在大众文化中引发强烈的共鸣和玩梗热潮,核心在于它极其精妙地用数字化、量化的方式,具象化了当代人“脑力被压榨、注意力被空耗”的职场常态,成为了新一代的反内耗代名词。
- AI时代打工人的“额度焦虑”: 现代人在职场上高频调教AI,写周报、跑代码。由于中文字符在模型底层切分时占用的 Token 往往是英文的 2-3 倍(一个汉字可能消耗 2-3 个 Token),导致大家在面临“输入超限”或“API 扣费太快”时产生了极大的精神内耗。如何通过精进提示词工程来“省Token”,成了最火的职场防卷技巧。
- “打工人精力”的黑话解构: 以前大家用“电量不足”来形容疲惫。但年轻人很快发现,“Token”这个词更精准——因为电量是连续的,而 Token 是一下一下被无意义的废话和形式主义会议给“扣掉”的。在看清世界是个巨大的草台班子后,大家开始用“别扣我 Token”来拒绝职场上的精神绑架,抢夺回生活的松弛感。
- 数字游民与独立开发者的核心生产力资产: 对于靠 AI 一个人活成一支军队的自由职业者来说,Token 就是真金白银。每天算力 Token 的转化率,直接决定了其独立站点的产出效率,让这个词成为了科技和自由职业圈的长线图腾。
“Token”怎么用?
该词广泛应用于 AIGC 提示词优化、大模型 API 付费教程、当代职场发疯文学文学创作、以及年轻人生活状态的标签化宣告中。
常见用法
- 大脑 Token 欠费: 形容因为连续加班、开会、断崖式衰老导致大半脑精疲力竭、完全不想思考。
- 省 Token 压缩法: 常见于提示词工程,指用极度精简、无废话的代码和框架锁死 AI 边界,防止大模型胡说八道。
- 情绪垃圾扣 Token: 调侃在社交或面对不靠谱的搭子时,由于对方不断单向宣泄负能量,导致自己的耐心值被迅速扣光。
例句
在设计 Prompt 的时候一定要注意控制上限,否则一旦长文超出模型的 Token 窗口,AI 就会直接选择遗忘开头的核心指令。( 说明大模型记忆力和信息吞吐量存在绝对的技术边际限制。 )
天天在微信群里陪那个奇葩长官玩欲擒故纵的心理战,我提供那点情绪价值还不够每天扣 Token 的。( 深刻写出了低质量职场沟通对个体精神总量的巨大损耗。 )
养一只哈基米最好的地方就是它从不消耗你的 Token,它只要看你一眼,就能给你自动充值满分的多巴胺。( 用动物无害真实的本能,反衬了人类世界算计沟通的疲惫。 )
💡 核心金句:
职场的本质就是一场 Token 的买卖——老板用工资购买你每天的精力额度。真正的高情商打工人,是把 Token 留给核心业务和自我提升,至于那些务虚的黑话和面子内耗,请直接在心里开启‘拒绝响应’。
AI底层逻辑与人脑精力的切分对比
根据 AI 的计算模型,文本和算力的消耗有着严密的结构划分:
| AI 算力层面的 Token(技术硬指标) | 现代人精神层面的 Token(人类黑话化) |
|---|---|
| 计费与切分单位: 英文一个单词约 1.3 个,中文一个汉字约 2-3 个 Token | 精力和耐心单位: 一句职场废话扣 5 个,一个奇葩长官的夺命 Call 扣 50 个 |
| 上限限制: 大模型的 Context Window(如 32K、128K),超出就会健忘 | 精力窗口上限: 长期熬夜导致精力缩减,容易引发断崖式衰老 |
| 优化手段: 依靠高阶提示词工程精简指令,锁死大模型运行空间 | 优化手段: 开启松弛感,启动防御性悲观,绝不为无意义的事内耗 |
相关词汇
常见问题
为什么中文在 AI 模型里消耗的 Token 比英文多这么多?
因为目前绝大多数主流大模型的底层分词器(Tokenizer)都是基于英文语料库训练和开发的。它们在处理英文时,可以轻松把一个完整的单词切分为一个 Token;而在处理中文时,由于中文复杂的编码和庞大的字库,算法往往要把一个汉字拆分成多个微小的子片段(Byte),这导致了中文在天然上就存在“Token 溢价”和算力吃亏现象。
怎么在【提示词工程】里做到极致的“省Token”?
“抛弃大白话,套用结构化框架。” 不要用商量的语气跟 AI 说大段的过场废话(比如“请你帮我想一想,如果你有空的话能不能写个…”)。直接使用 Role-Task-Constraint 的指令矩阵,用中括号、冒号锁死信息。这样不仅能砍掉 60% 的废话 Token,更能强力阻断AI幻觉,让产出一步到位。
职场上感觉自己“天天大脑 Token 欠费”该怎么自救?
开启强烈的边界感和松弛感。当长官又召集大家开那些没有明确产出、纯粹为了对齐颗粒度的务虚会议时,让你的身体坐在那里当个背景,大方开启“防御性悲观”和“脑内 Citywalk”。不让那些废话信息进入你的内存,你就能成功保留核心算力去过下班后的真实生活。
成为独立站长或数字游民也需要精算 Token 吗?
这几乎是数字游民个体户的利润护城河。当你在用 AI 自动化批量跑文章、跑翻译、或者训练自己的特定外挂客服时,Token 就是你的原材料成本。学会用最少的成本、最高分值的 Rank Math 绿灯指令去撬动 Google 的海量搜索自然流量,这才是数字时代真正的“地理套利”高级黑客。